 Auf Mastodon ansehen
Zu Beginn gilt es, ein paar Fragen zu beantworten:
- Was ist Vibe-Coding?
Vibe-Coding bezeichnet eine Art der Softwareentwicklung, bei der nahezu ausschließlich der Prompt eines großen Sprachmodells (LLM) (z. B. GPTs wie Claude oder ChatGPT) bedient wird, um den für die Software erforderlichen Quellcode zu generieren. Vibe-Coding arbeitet mit den Mitteln des Prompt-Engineerings. Anders als die qualifizierte Softwareentwicklung, die Überprüfungen und Tests des Quellcodes und des Produkts auf Fehlerfreiheit durch Fachpersonal einschließt, soll Vibe-Coding keine Vorkenntnisse oder Ausbildung erfordern. (Aus Wikipedia.) - Kritische Einordnung
Ich stehe der Verwendung von KI grundsätzlich kritisch gegenüber. Insbesondere beim Vibe-Coding besteht die Gefahr, unwartbaren und sicherheitskritischen Code zu generieren. Vibe-Coding wird in der Regel von Personen angewendet, die keine oder unzureichende Ahnung von Softwareentwicklung haben. - Warum dann diese Artikelserie?
Dafür gibt es drei Gründe: Ich möchte die freie Software UniTree migrieren (dazu später mehr), ich wollte selbst wissen, wie weit man mit Vibe-Coding kommt, und ich möchte an einem praktischen Beispiel die Gefahren aufzeigen.
Inhaltsverzeichnis
Teil 1: Motivation (das ist dieser Artikel)
Teil 2: Treenotes
Teil 3: UniTree
Motivation
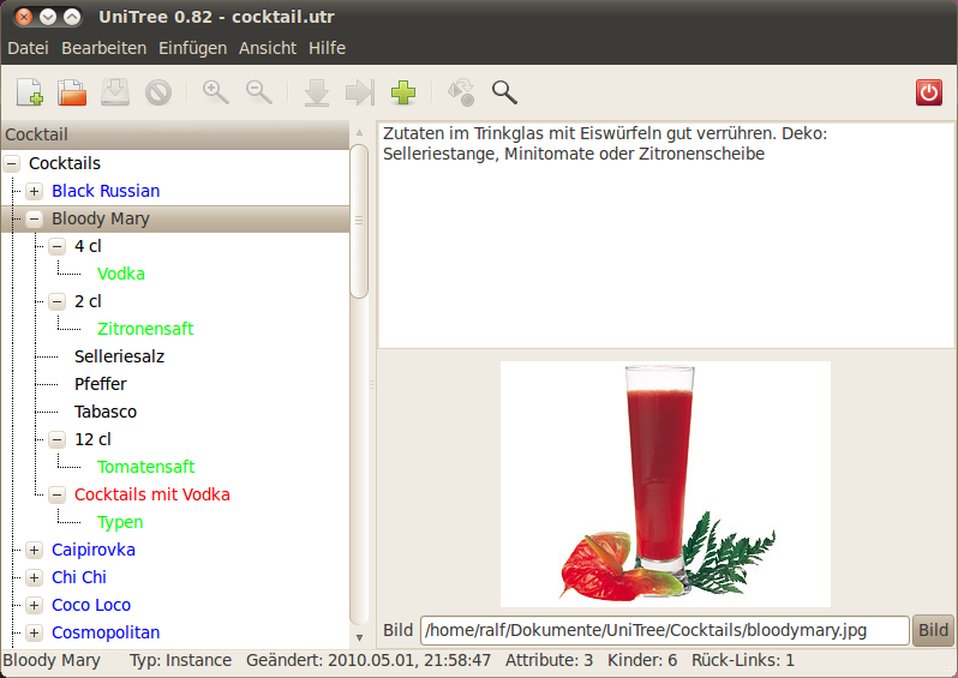
Im Jahr 2009 habe ich eine Software namens UniTree geschrieben. Im Titelbild seht ihr einen Screenshot davon.
UniTree ist ein universelles Werkzeug zur strukturierten Ablage von Textinformationen. Es eignet sich für vielfältige Einsatzzwecke wie z. B. Ideensammlung, Notizblock, kleinere Datensammlungen, Verwaltung von Projekten, Hilfesammlung usw. UniTree läuft auf allen Plattformen, die Python 2.6 und GTK unterstützen.
Zu den Funktionen von UniTree gehören:
- Strukturierter Baum
- Baum mit Verweisen und Rück-Verweisen
- Texteditor mit Einrück- und Aufzählungs-Automatik
- Zusatzfelder (Langtext, Kurztext, Datum, Boolean, Liste, Links, Bildern)
- Baumsuche und Volltext-Suche
- Journal
- Automatische Schlagwort-Verlinkung
- Wortergänzung und Textbausteine auf Tastendruck
- Liste der zuletzt bearbeiteten Themen
- Autosave
- Import und Export im XML-Format (mit XSL-Formatierung)
Die Migration der 3400 Zeilen Python2-Code (mit Gtk2) zu Python3 (mit Gtk4 und Libadwaita) ist mir nie gelungen.
Mir ist die Migration wichtig, weil ich damals mit UniTree ein paar gute Ideen umgesetzt habe. Auf den ersten Blick erscheint die Anwendung als Note-taking-App wie z. B. ZIM oder Joplin. Ich sehe UniTree eher als hierarchische Datenbank, was man bei einem näheren Blick auf den Baum sieht. Dort wechseln sich in der Hierarchie zwei Knotentypen ab. Ich habe sie damals Kategorien (schwarz) und Instanzen (blau) genannt. Der Baum beginnt mit einem Kategorieeintrag (Cocktail). Darunter befinden sich zwingend Instanzeinträge (Black Russian, Bloody Mary, usw.). Darunter muss wieder zwingend ein Kategorieeintrag folgen.
Für jede Kategorie werden Attribute (Datenbankfelder) für die darunterliegenden Instanzen konfiguriert. Beispiel: Die Kategorie "Cocktail" definiert die Felder: Beschreibung, Bilddatei und Link zur Bilddatei. Bei der Instanz "Bloody Mary" stehen genau diese Felder zur Verfügung und können ausgefüllt werden.
Neben Kategorien und Instanzen gibt es noch Links (grün) und Rück-Links (rot). Die Links referenzieren Instanzen, die sich anderswo im Baum befinden. Rück-Links sind Links, die von anderer Stelle im Baum auf diese Instanz verweisen. Mit dieser Architektur lässt sich fast alles abbilden, was einem so einfällt. UniTree bietet eine mächtige Suche, über die sich die erwähnte Cocktail-Datenbank abfragen lässt. "Welche Cocktails kann ich mit meinem Bestand mixen?", lassen sich damit beantworten.
Da ich keine andere Anwendung kenne, die dieses Konzept implementiert, lasse ich mich auf die Wiederbelebung von UniTree ein.
Geht das mit Vibe-Coding?
Hinter dieser Frage verstecken sich zwei Fragen. Kann ich die alte Anwendung migrieren? Kann ich die Idee der alten Anwendung mittels Vibe-Coding neu erstellen? Bevor ich mit dieser Artikelserie begann, habe ich diese Fragen einer KI gestellt und sie mit dem alten Material gefüttert. Die Antwort war zurückhaltend und eher skeptisch. Sie verwies darauf, dass sich in fast 20 Jahren bei Python und Gtk viel verändert hat. Falls ich eine gute Spezifikation zur Hand hätte, könnte es dennoch gelingen.
Ich stelle fest:
- Die Migration auf Basis eines uralten Codes ist eher schwierig.
- Die Neuerstellung aufgrund einer guten Spezifikation ist zielführender.
Das erinnert mich an ein Berufsfeld, in dem ich 10 Jahre lang tätig war: CASE - Computer Aided Software Engineering. Auch damals war eine perfekte Spezifikation, eine Voraussetzung für guten Code. Deshalb werde ich im zweiten Teil dieser Serie versuchen, UniTree auf einer Spezifikationsbasis zu bauen, bzw. zu vibe coden.
Warum ist das im Kontext von GNU/Linux.ch relevant?
Es gibt unzählige freie Software-Projekte, die neue Konzepte und gute Ideen verfolgen, jedoch aufgrund von Zeitmangel, Unfähigkeit (das meine ich nicht negativ) oder Prioritäten nicht hinreichend gepflegt und weiterentwickelt werden. Falls KI-basierte Unterstützung einen Beitrag leisten kann, um Open-Source-Projekte am Leben zu erhalten, ordne ich das im Moment vorsichtig positiv ein.
Titelbild: UniTree Screenshot
Quellen:
https://de.wikipedia.org/wiki/Vibe-Coding
https://wiki.ubuntuusers.de/Archiv/UniTree/
https://www.rum3ber.ch/index.php/projekte/unitree
https://de.wikipedia.org/wiki/Computer-aided_software_engineering


Hervorragend. Der Artikel kommt genau richtig. Ich habe mich gerade mit der selben Problematik beschäftigt. Leider ist der Resourcenverbrauch sehr hoch. Ich lese immer wieder, dass einige Leute allen Code, der aus KIs kommt, ablehnen. Der Zug ist längst abgefahren.
Bin seit einiger Zeit mit lokaler LLM, passendem Rechner und OpenCode unterwegs. Meine Erfahrung zum "Neu-Programmieren" alter Programme/Skripte: Ich lasse die LLM erstmal eine AGENTS.md erstellen, die "grob" das alte Konzept beschreibt (ohne die Programmiersprachenspezifischen Sachen zu beschreiben). Das passe ich manuell an und diskutiere mit der LLM sehr lange alle möglichen Ideen und Verbesserungen, bis es eine perfekte Spec ist. Dann erst lasse ich umsetzen und bekomme eine ziemlich gute erste Version. Ab da an lasse ich Sourcecode und AGENTS.md stets nur parallel mitpflegen.
Ist auch meine Vorgehensweise. Immer erst konzipieren lassen, alle möglichen Varianten ausdiskutieren, dann iterativ umsetzen lassen, alles automatisch nachdokumentieren lassen, und dabei Tests mit entwickeln lassen.
Nachtrag zu "Vibe-Coding wird in der Regel von Personen angewendet, die keine oder unzureichende Ahnung von Softwareentwicklung haben.". Äh, nö. :-) Bin studierter ITler und programmiere viel und in vielen Sprachen, nur jetzt bei einigen Sachen mit Unterstützung, wobei ich die LLM immer nur schrittweise was umsetzen lasse und nicht blind programmieren lasse und das dann übernehme.
Bei uns in der Firma werden KI-Unterstützungen von den Devs mittlerweile überall angewendet. Komplexe Produkterweiterungen werden damit aufwändig konzipiert und umgesetzt, ebenso wie kleinere Erweiterungen. Die Designer arbeiten an Design to Code. Kleinere Kunden-Demos von Content Management Systemen im Headless-Umfeld werden von den Herstellern bereits jetzt komplett mit Design to Code aus Figma heraus umgesetzt.
"Vibe-Coding wird in der Regel von Personen angewendet, die keine oder unzureichende Ahnung von Softwareentwicklung haben" bekommt also auch von mir ein Nope. Vibe Coding und Design to Code sind bereits da und werden bleiben, auch im professionellen Umfeld, gerade auch von den Senior Devs, die daran echt Freude haben.
Das ist dann aber auch kein Vibe Coding.
In unserem Unternehmen arbeiten Entwickler auch ständig mit KI - Umsetzung, Review und Test wird ständig mit Unterstützung durchgeführt. Dabei sitzt der Mensch aber immer daneben und prüft den Output.
Beim Vibe-Coding halluziniert man sich das ganze Ding herbei, ohne groß etwas zu prüfen. Zwischen diesen Herangehensweisen ist ein gewaltiger Unterschied.
Dem werde ich gespannt folgen. 😊
Vibecoding klingt interessant, wenn man damit Projekte realisieren kann, die bisher niemand umgesetzt hat. Stellt sich halt immer die Frage, wie gut, sicher und wartbar der von einer LLM produzierte Code ist. Lokale Modelle sind schon mit der Dokumentation von FoundryVTT überfordert. XD