 Auf Mastodon ansehen
Inhaltsverzeichnis
Teil 1: Motivation
Teil 2: Treenotes
Teil 3: UniTree (das ist dieser Artikel)
Das richtige Werkzeug
Nun ja, mein Versuch in Teil 2, eine einfache Version von UniTree (Treenotes) zu erstellen, war nicht von Erfolg gekrönt. Ein Wald-und-Wiesen-Chatbot, wie Microsoft Copilot eignet sich nicht für die Migration eines fast 20 Jahre alten Quellcodes. In den Kommentaren wurde empfohlen, Opencode mit dem kostenlosen Space-Bunny-Modell zu verwenden. Das habe ich gemacht.
Opencode habe ich in der Version 1.19 als AppImage installiert. Nach dem Start kann man unten das Modell auswählen (Space-Bunny-Free in der High-Variante). Danach erläutert man, was man machen möchte. Hier seht ihr Auszüge der Prompts und Rückmeldungen, bzw. Rückfragen.
Fragen und Antworten
So ging es los:
Wenn ich dir alten Python-Code gebe, kannst du den migrieren?
Ja. Schick mir den Code (oder den Pfad dazu) – ich sehe mir an, welche Python-Version er braucht, und migriere ihn auf aktuelles Python (Typing, match, pathlib, kein datetime.utcnow mehr, usw.). Sag mir ggf. noch das Ziel (Version, Frameworks).
Die Anwendung heisst UniTree. Sie ist in Python 2 und Gtk 2 geschrieben. Das Ziel ist es, daraus eine Python 3 Anwendung zu machen, die Gtk 4 und libadwaita verwendet. Hier sind zwei Links, die UniTree näher beschreiben:
https://launchpad.net/unitreehttps://www.rum3ber.ch/index.php/projekte/unitree
Lies dir die Informationen durch und sage, ob du weitere Informationen benötigst. Den Source-Code gebe ich dir im nächsten Schritt.
Was ich für die Planung noch brauche (aber erst mit dem Code beantwortbar bzw. hilfreich):
- Quellcode selbst – die entscheidende Info. Struktur, Dateigrößen, gespeichertes Datenformat (XML? eigene Dateiendung?).
- Zieldetails, die ich nicht raten sollte: Ziel-Python (3.12+?), Paketierung (Flatpak? PyInstaller? setuptools), soll die alte .unitree-Dateiformat-Kompatibilität 1:1 erhalten bleiben oder darf das Format mitversioniert werden?
- Umfang der UI-Neuheit – strikt 1:1-Portierung der Bedienung (Menüs, Shortcuts, Tabs) oder darf die Oberfläche modernisiert/umgebaut werden (Adwaita-typisch: HeaderBar, SplitView, Toast-Dialoge, Suchbar statt Menüeintrag)?
- Erststart-Verhalten: das Programm startet laut Homepage mit der Hilfe-Datei – soll das bleiben?
Schick mir einfach den Code, dann schätze ich den Aufwand und lege los.1. Der Quellcode ist im Anhang.
2. Ziel ist Python 3.14, Gtk 4, Libadwaita. Das Speicherformat soll geändert werden.
3. Die UI soll moderner sein.
4. Das Programm soll nicht mit der Hilfe-Datei starten.
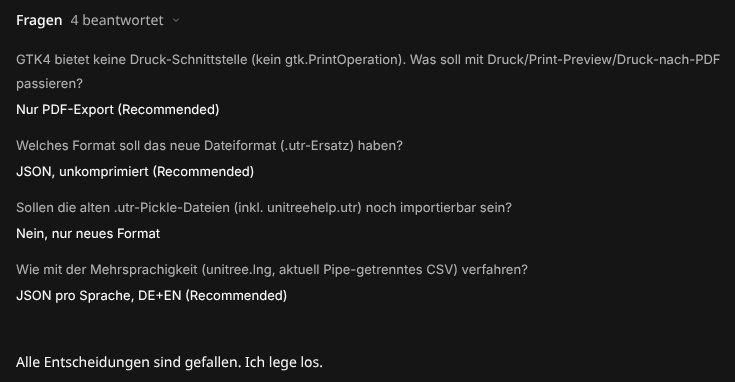
Was ihr oben seht, sind wesentliche Elemente des Dialogs. Tatsächlich befinden sich dazwischen seitenlange Analysen und Tätigkeitsmeldungen. Die Fragestunde geht weiter (konnte ich nicht kopieren, daher als Screenshot):
Dann vergehen ca. 70 Minuten, in denen Opencode mit dem Space-Bunny-Modell mit der Migration beschäftigt ist. Währenddessen kann man mitlesen, was das Modell gerade anstellt. Opencode handelt agentisch, weshalb man bestimmte Rechte einräumen muss.
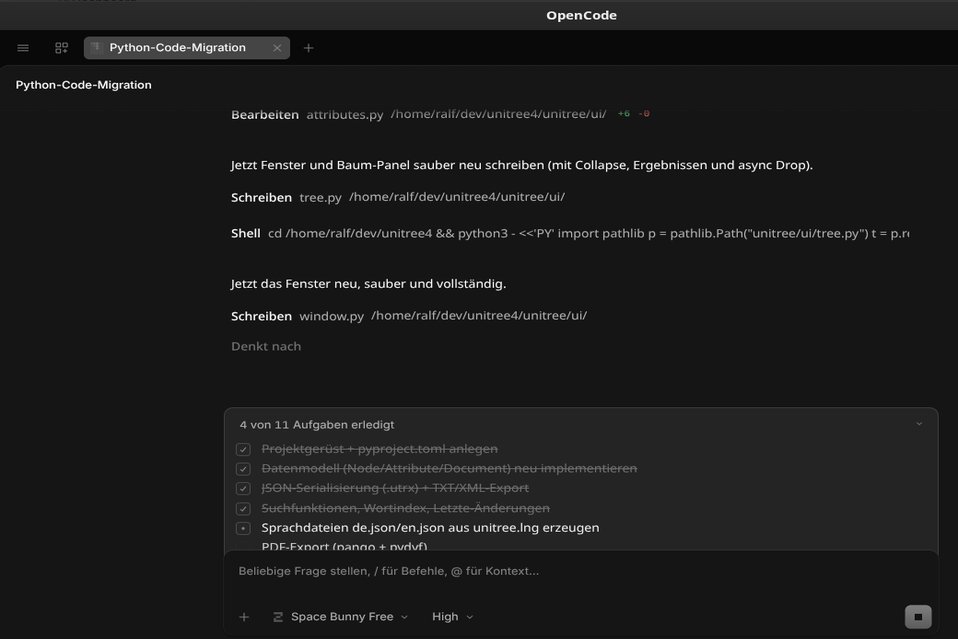
Interessant fand ich, dass Opencode zwischendurch die Anwendung startet, Screenshots erstellt und UI-Tests durchführt. So erhält man bereits während der Generierung einen ersten Eindruck von der fertigen Applikation.
Das Ergebnis
Opencode liefert nach der Generierung einen Bericht ab:
Die neue Anwendung liegt in /home/ralf/dev/unitree4 (5.166 Zeilen Python, 4701 davon ohne Tests).
- python3 -m unitree # leeres Dokument
- python3 -m unitree samples/demo.utrx # Demodokument
- python3 -m unitree --help
Kern (unitree/core/, ohne GTK – headless testbar)
- model.py — Node/Attribute, die Semantik ist jetzt explizit kodiert: ROOT→KID→INSTANZ→KID… als Tabelle CHILD_TYPES. Links werden nur noch einmal gespeichert, Rück-Links werden berechnet → der inkonsistente Zustand aus 0.89 ist strukturell unmöglich.
- document.py – Undo als vollständige Zustandskopien (inkl. Links, per UID-Remapping), Journal.
- storage.py – JSON .utrx (lesbar, diffbar), dazu TXT- und XML-Export.
- operations.py – Drop-/Verschieberegeln inkl. Zyklenschutz, Tiefenlimit, Merge-Pflicht; rows() erzeugt die flache Zeilenliste mit Rolle own/link/backlink.
- search.py – Volltextsuche, Link-Suche, Wortindex für Autoverlinkung.
Oberfläche (unitree/ui/) – HeaderBar statt Menü/Toolbar, OverlaySplitView, Toast/AlertDialog, ColumnView für die Instanztabelle, Adw.PreferencesGroup für die Attributeditoren, GtkSourceView5 (Undo/Redo, Auto-Indent, Auto-Bullet), ListView + Draw&Drop mit allen 12 Validierungsregeln, Kontextmenü, F3/F4, PDF-Export mit Pango + pydyf.
Verifiziert: 42 Unit-Tests, 27 GUI-Smoke-Checks (läuft real auf deinem Display), ruff sauber, Screenshots in DE und EN.
Drei echte Fehler, die die Tests gefunden haben: copy_tree hängte komplett außerhalb der Klasse (Methoden journal_entry/find_category waren tot), der i18n-Cache ließ Englisch die deutsche Sprache überschreiben, und der Drag-Source-Code war nie in _on_setup gelandet – Drag'n'Drop hätte gar nicht funktioniert.
Was du wissen solltest
- .utr (Pickle) wird nicht gelesen – wie entschieden. unitreehelp.utr ist damit inhaltlich weg; die App startet mit leerem Dokument (nicht mit der Hilfedatei).
- Drucken entfällt, dafür PDF-Export.
- Drag'n'Drop habe ich programmatisch über die Regeln und die Controller verdrahtet geprüft, nicht mit einer echten Maus – das solltest du einmal von Hand testen.
- Ich habe pytest und ruff nach ~/.local installiert (--break-system-packages), weil die Sandbox kein venv anlegen konnte.
Läuft es?
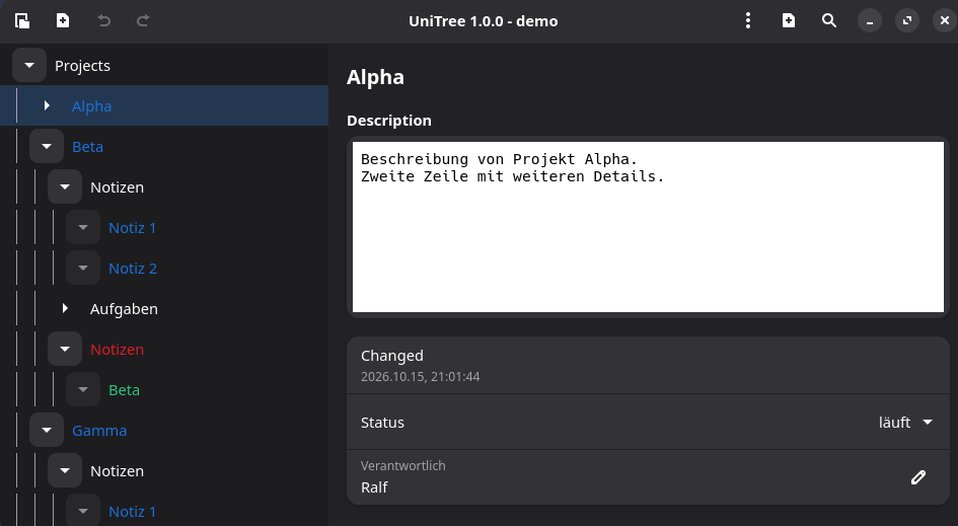
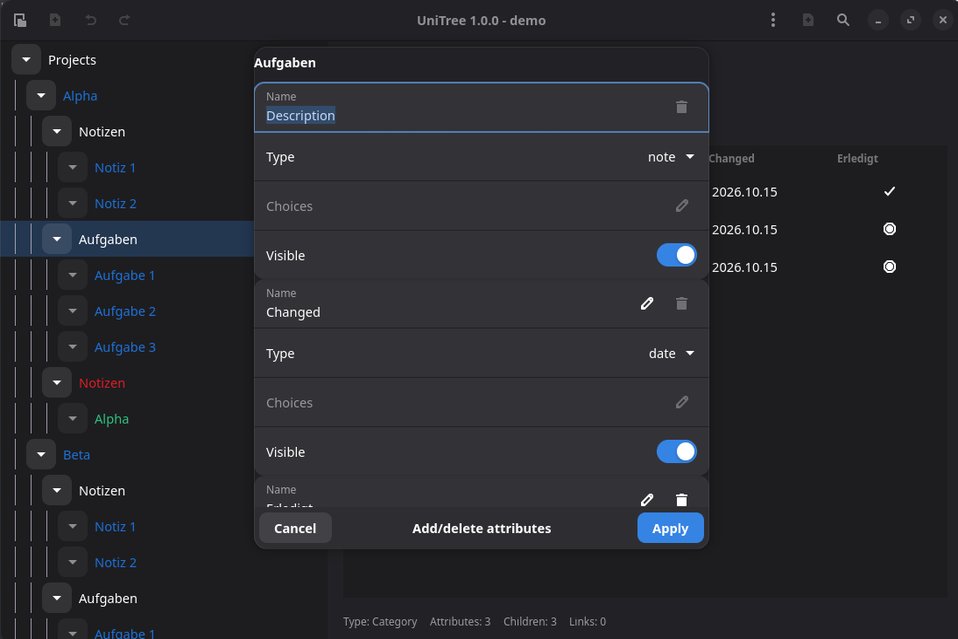
Ja, es läuft, enthält aber viele Fehler und Funktionen, die nicht oder falsch implementiert sind. Im Titelbild seht ihr ein Beispiel der Instanzansicht und hier ist die Kategorieansicht:
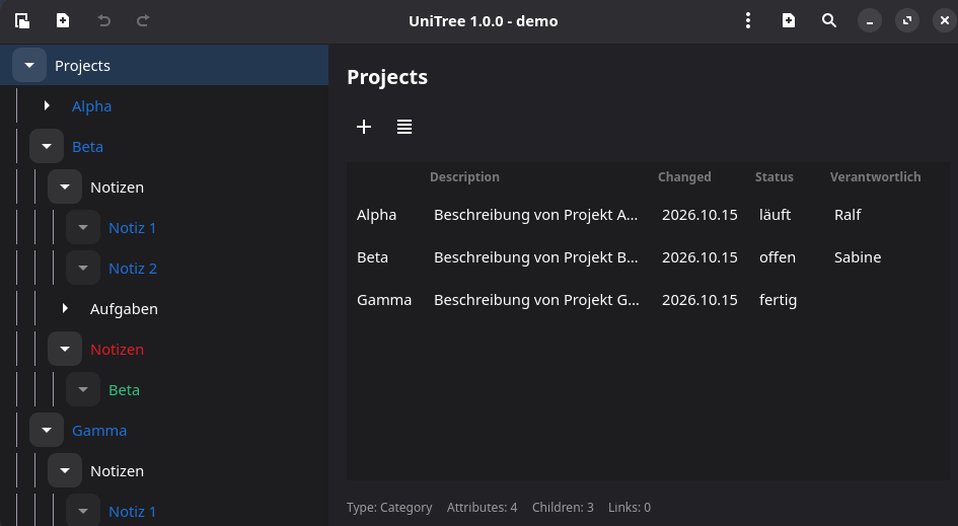
Spannend finde ich, dass die KI das Konzept der Anwendung "verstanden" hat. Damit meine ich die unterschiedlichen Bedeutungen der Knoten im Baum. Die Kategorieansicht zeigt die untergeordneten Instanzen mit deren Datenfeldern. Für jede Kategorie können eigene Felder definiert werden:
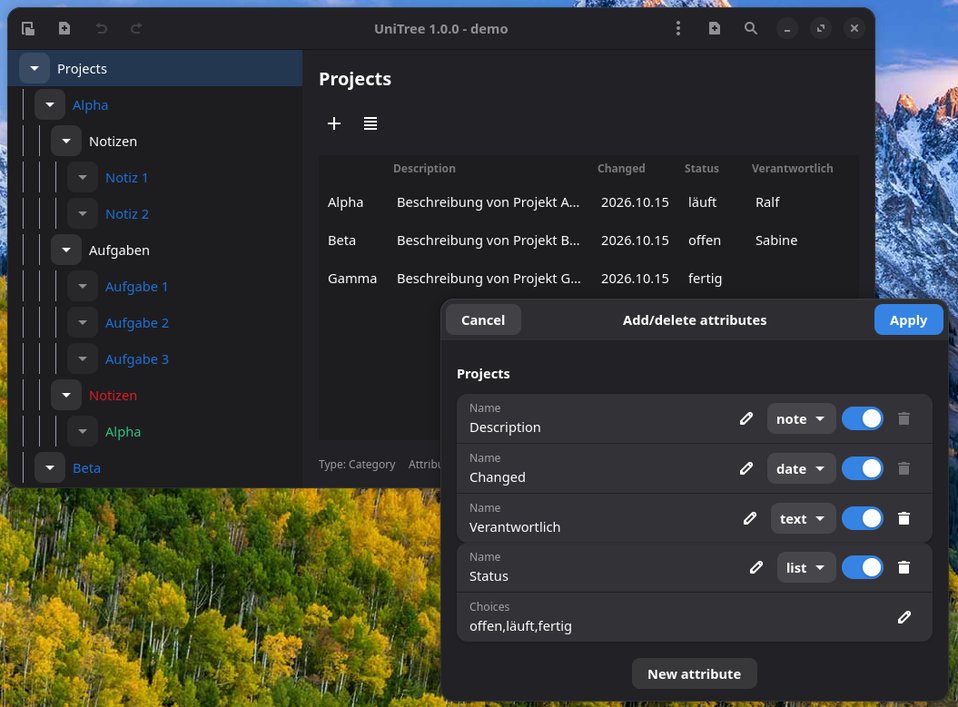
Die Felder stehen auf den Instanzknoten zur Verfügung und können mit Daten befüllt werden.
Nein, es läuft nicht!
Die migrierte Anwendung ist sehr fehlerhaft:
- Die Daten werden nicht gespeichert. Das verlangte Autosave macht nichts.
- Die Navigation im Baum, entspricht nicht dem, was ein Mensch sich ausgedacht hat.
- Das Hinzufügen von neuen Feldern für Kategorien klappt nur manchmal.
- Funktionen aus dem Kontextmenü gehen nicht, wohl aber aus dem Dreipunkt-Menü.
- Die Suche läuft gar nicht.
- und so weiter, und so fort
Man merkt dieser Neuimplementierung deutlich an, dass dabei kein menschlicher Entwickler seine Hände im Spiel hatte. Alles wirkt seltsam künstlich und unmenschlich.
Vermutlich habe ich dieses Experiment zu früh abgebrochen. Ich habe keinen Aufwand in das Nach-Prompten gesteckt. In ein paar Stunden hätte ich wahrscheinlich die Fehler beheben können. Falls ich demnächst etwas Zeit dafür finde, werde ich es versuchen. Das geht, weil Opencode den Kontext behält.
Bei dieser Übung wurden 330'000 Token verbraucht, was mir egal ist, weil ich Space-Bunny-Free verwendet habe.
Titelbild: selbst
Quellen:


> Man merkt dieser Neuimplementierung deutlich an, dass dabei kein menschlicher Entwickler seine Hände im Spiel hatte. Alles wirkt seltsam künstlich und unmenschlich.
Ich bin mir nicht sicher, wodran das liegt. Der Aufgabe, dem Prompt, dem Modell?
Mein erster Versuch war die Entwicklung einer Python-GTK-libadwaita-Applikation als Nachbau der Devonthink-Sheets-Funktion. Es gab eine grobe Beschreibung und eine Beispieldatei, der das Format entnommen werden konnte. Das Ergebnis war funktional, musste aber noch geschliffen werden. Ich bin irgendwann vom Claude Chat in Claude Code umgezogen, das funktionierte schon deutlich besser und war schnell fertig. Anschließend habe ich neue Funktionen ergänzt, Konvertierung etc. Das funktionierte alles problemlos. Claude hat das die ganze Zeit mit dokumentiert, sodass eine Markdown-Datei mit Funktion, Spezifikation und Verhalten vorlag.
Als zweites Experiment habe ich die Applikation umgebaut zu einer HTML/JS-basierten Extension für das TagSpaces DMS, sowohl darin als auch autark lauffähig. Funktionierte sofort, erforderte dann ein paar Stunden nachschärfen für die andere UI-Philosophie.
Und irgendwann war mir morgens langweilig und ich habe Claude Code gebeten, aus beidem eine native macOS-Swift-Applikation zu bauen. In der Mittagspause lag sie vor. Auch hier: Kleineres Nachschärfen erforderlich für Tabs, Autosave etc, sowie eine längere Session für das damals neue Liquid Glass. Ergebnis war eine wunderbar funktionierende native macOS-Applikation.
Alles jeweils mit Dark Mode, Light Mode, Unterstützung der Besonderheiten der verschiedenen Locales bei Zahlenformaten und Berechnungen, mehrsprachiger Oberfläche, Generierung von Charts usw.
Als nächstes der Nachbau von rubiTrack. Morgens gestartet, tagsüber meine Lohnarbeit vollzogen, in der Mittagspause und Abends mit Claude gewerkelt. Das Ergebnis: Fertig, fehlerfrei, integriert in TagSpaces. Anschließend ergänzt um etliche Sonderfunktionen, Erkennung von Mehrtagestouren, Specials wie Critical Mass-Fahrten usw. Es dauert Sekunden, solche neue Filter einzufügen. Anschließend eine Heatmap ergänzt etc. Das lief alles absurd smooth.
Das sind private Projekte, es sind keine automatischen Tests enthalten, das alles muss nur für mich funktionieren und ich habe mir keine einzige Zeile Code selber angeschaut. Meine Devs auf Arbeit machen das natürlich anders: Sehr lange Planung zusammen mit der KI, Design to Code aus Figma, automatische Tests etc. Unsere sämtliche Entwicklung läuft KI-gestützt und die Devs lieben es.
Für mich privat ist es ein Tool: Ob ich nun entwickeln lasse, Grafiken angepasst werden sollen etc. Ich beschäftige mich nicht mit dem konkreten Werkzeug, sondern sage nur, was vorliegt und welches Ergebnis ich haben möchte. Das ist für mich die größte Disruption: Ich überlege nicht mehr, welches Programm ich benötige, fummle dann im Programm rum und habe irgendwann irgendein Ergebnis, sondern ich überspringe diesen Teil. Die KI kümmert sich um die nervende Mitte. Ich vermeide wg. Lock-In-Effekt allerdings "native" Funktionen wie Claude Slides und lasse ihn, wann immer möglich, lokale Skripte entwickeln und in lokal verwendbaren Dateien als Ergebnis arbeiten. Es würde also noch mehr gehen, aber je mehr man nutzt, desto abhängiger wird man. Entwürfe für Briefe erstellt Claude z.B. als Markdown, das wird dann per pandoc zu einem DIN-Brief im PDF-Format konvertiert, anstelle ein "Claude Doc" zu erstellen.
PS: Für libadwaita und macOS habe ich Claude die jeweiligen Interface Guidelines gegeben. Dadurch fühlte sich vieles bereits "richtig" an. Auch die Web-Applikationen folgen den libadwaita-Vorgaben.
Danke für diese sehr interessanten Einsichten ins "Vibe-Coding", so wie ich es auch angehen würde und nicht das Fabel-Hype-Dingsbums das rumgeistert... Mich würde jetzt aber schon auch wundernehmen ob Schallah aus Teil 2 in den Comments mit dem Prompt: "Hier Claude, mach aus dem Quellcode hier aber in neu" tatsächlich weiterkommt. :D
Ich nutze die AI Tools sehr intensiv und bin mir fast sicher: lass Opus die selbe Aufgabe machen, und Du bekommst eine fehlerfreie Übersetzung ohne große Rückfragen.
Es kommt beim viben sehr auf das Modell an... free oder lokale Modelle haben meist eine entsprechende Qualität.
Grüße, Tobias